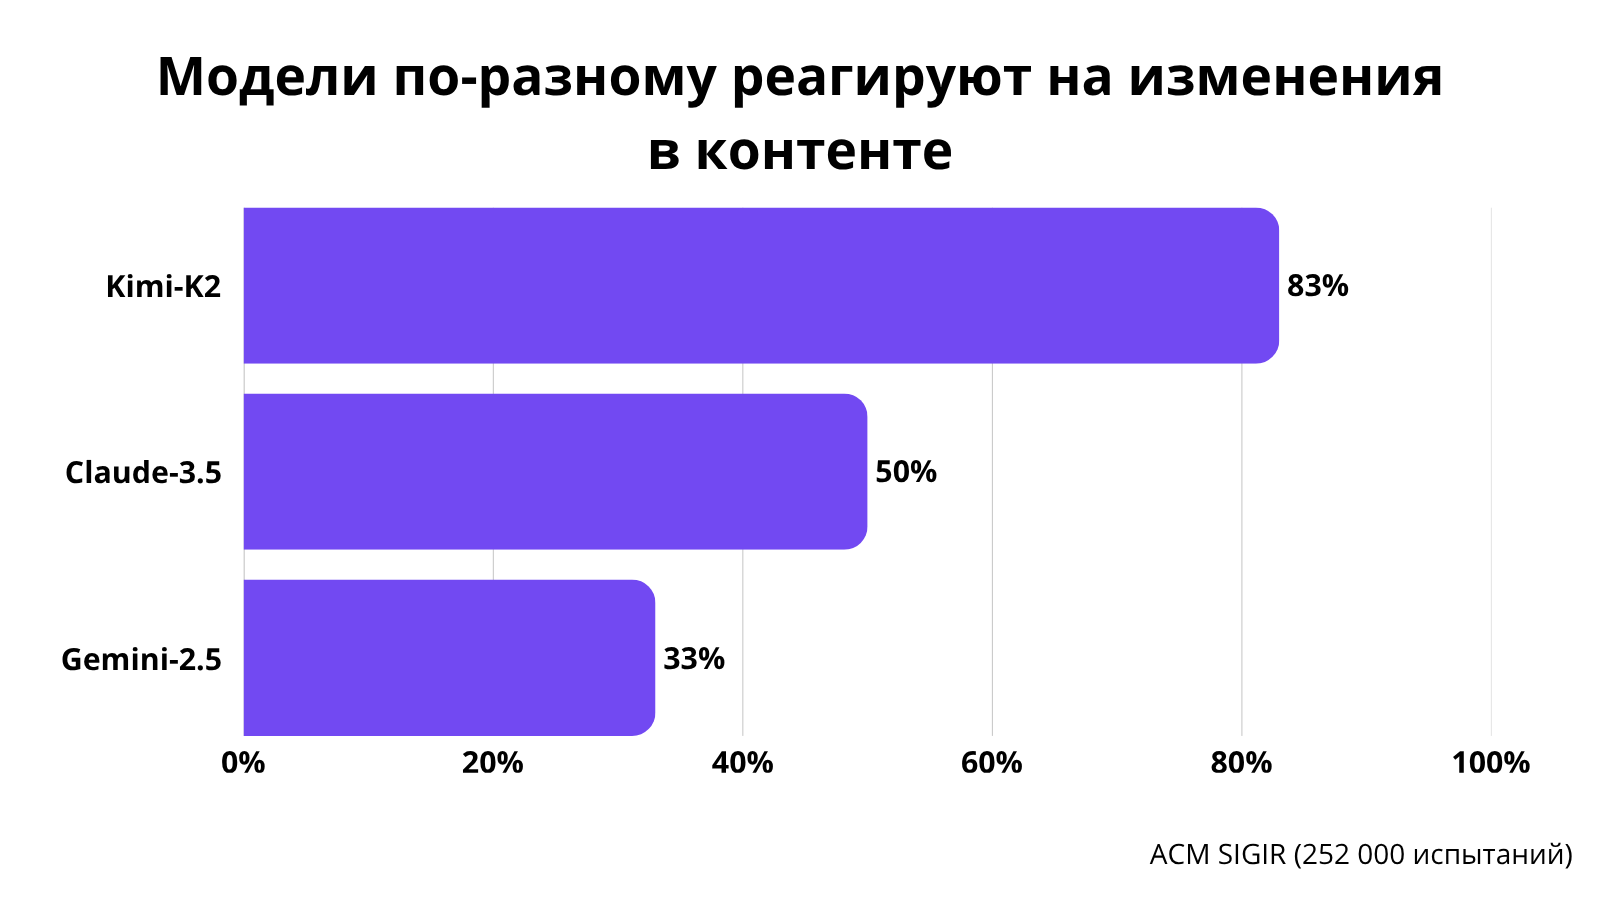
ИИ-модели не просто отвечают на вопросы. Они принимают решения о том, какой контент цитировать. И делают это по-разному. Исследование ACM SIGIR, основанное на 252 000 испытаний, показывает: стратегия, которая работает для одной модели, может не работать для другой. Разница в чувствительности к контенту достигает 50 процентных пунктов.
Разная чувствительность к контенту
Исследование протестировало шесть моделей в контролируемой среде. Результат: Kimi-K2 показал самую высокую чувствительность к контентным факторам - 83% факторов оказались значимыми. Claude-3.5 - 50%. Gemini-2.5 - 33%.
Это означает, что Kimi-K2 реагирует почти на любые изменения в контенте. Если вы добавите цену, измените заголовок или обновите данные, модель это заметит. Gemini-2.5, наоборот, реагирует только на треть факторов. Многое из того, что вы делаете, остаётся для неё незамеченным.
Для бизнеса это означает, что нельзя использовать одну стратегию для всех моделей. То, что работает для Kimi-K2, может не работать для Gemini. Нужно понимать, какие факторы значимы для каждой модели, и адаптировать контент под них.
Бинарные решения
Исследование выявило ещё одну важную закономерность. У Gemini и Claude 67-78% значимых факторов дают экстремально большие эффекты. Это указывает на бинарные границы решений.
Что это значит на практике? Модель либо цитирует контент, либо нет. Нет промежуточных состояний. Если контент соответствует определённым критериям, он попадает в ответ. Если нет - не попадает. Это не постепенное улучшение, а резкое переключение.
Для бизнеса это означает, что нужно точно соответствовать критериям модели. Не «улучшать» контент постепенно, а делать его таким, чтобы он проходил бинарный фильтр. Если модель требует наличия цены, а её нет, контент не будет процитирован.
Четыре фактора, по которым согласны все модели
При всех различиях есть четыре фактора, по которым все шесть моделей согласны. Это тематическое соответствие, цена, свежесть и позиция.
Тематическое соответствие означает, что контент должен отвечать на запрос пользователя. Если запрос о ценах, а контент о функциях, модель не будет его цитировать. Цена - конкретные данные о стоимости. Свежесть - актуальность информации. Позиция - место в списке или структуре ответа.
Эти четыре фактора - фундамент. Без них не работает ничего. С ними - есть шанс попасть в ответ. Но для полной видимости нужно учитывать и другие факторы, которые различаются между моделями.
ChatGPT и Google AI Overviews: разные источники
Исследование Peec AI показывает, на какие источники опираются разные платформы. ChatGPT использует Wikipedia, Reddit, Forbes. Google AI Mode и AI Overviews - YouTube, Reddit.
Это означает, что для видимости в ChatGPT нужно присутствовать в Wikipedia и Reddit. Для видимости в Google AI Mode - на YouTube и в Facebook. Стратегия для одной платформы не работает для другой.
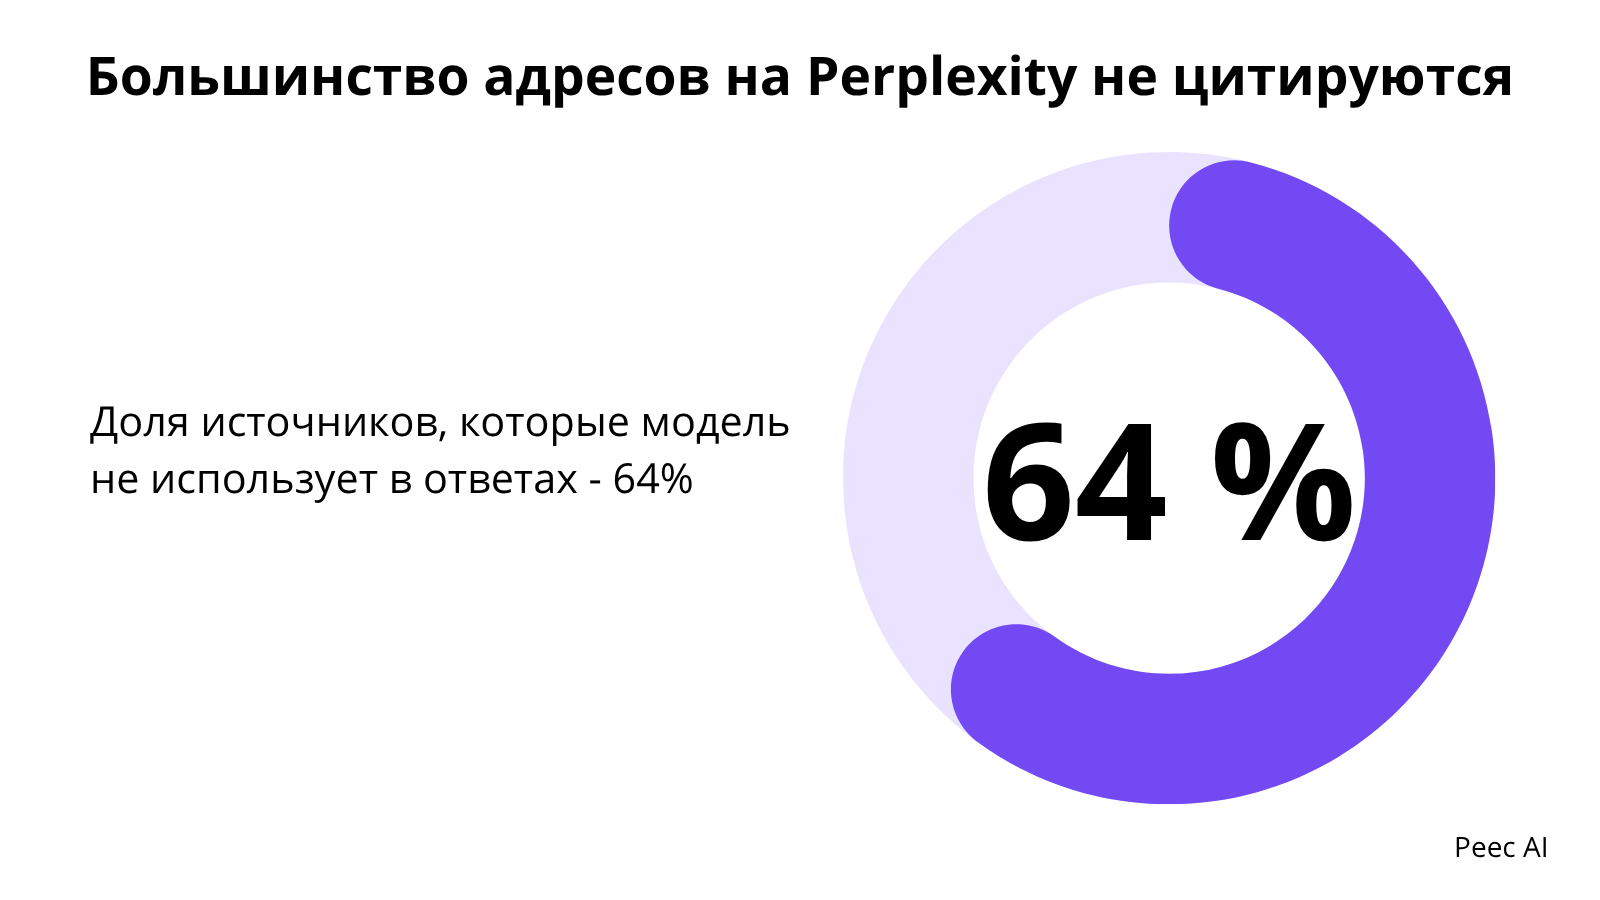
На Perplexity 64% адресов не цитируются. Топ-6% источников дают почти половину всех цитирований. Это означает, что конкуренция за место в топе Perplexity очень высокая. Но если вы туда попадаете, получаете непропорционально большую долю видимости.
Разметка работает в момент запроса
Исследование на платформе Zenodo предлагает модель плотности упоминаний. Цитирование в ИИ управляется плотностью упоминаний бренда в двух корпусах: замороженном обучающем корпусе и живом корпусе поискового извлечения.
Структурированные данные - это функция времени извлечения, а не времени обучения. Это означает, что разметка помогает ИИ извлечь информацию в момент запроса, но не влияет на то, что модель «знает» о бренде из обучающих данных.
Большинство инструментов оптимизации для ИИ воздействуют на меньший из двух слоёв. Они работают с разметкой и структурой страницы, но не с обучающим корпусом. Это означает, что их эффект ограничен. Для полной видимости нужно работать с обоими слоями: и с тем, что модель знает, и с тем, что она может извлечь в момент запроса.
Что это значит для бизнеса
Модели разные, стратегии разные. Чувствительность к контенту варьируется от 33% до 83%. Нельзя использовать один подход для всех.
Бинарные решения требуют точного соответствия. У Gemini и Claude 67-78% факторов дают экстремальные эффекты. Нужно точно соответствовать критериям, а не «улучшать» постепенно.
Четыре фактора - фундамент. Тематическое соответствие, цена, свежесть, позиция. Без них не работает ничего.
Источники различаются по платформам. ChatGPT опирается на Wikipedia и Reddit. Google AI Mode - на YouTube и Facebook. Нужно присутствовать там, где ищет ваша аудитория.
Разметка работает в момент запроса. Но не влияет на обучающий корпус. Для полной видимости нужно работать с обоими слоями.
Что делать бизнесу прямо сейчас
Проверьте, как ваш бренд выглядит в разных моделях. Задайте вопросы в ChatGPT, Perplexity, Claude, Gemini, Алисе и Google AI Overviews. Появляетесь ли вы в ответах? Если нет, вы невидимы для этой модели.
Адаптируйте контент под каждую модель. Учитывайте, какие факторы значимы для каждой. Kimi-K2 реагирует на 83% факторов, Gemini - на 33%. Стратегия должна быть разной.
Обеспечьте наличие четырёх ключевых факторов. Тематическое соответствие, цена, свежесть, позиция. Это фундамент, без которого не работает ничего.
Работайте с источниками, которые использует каждая платформа. Wikipedia и Reddit для ChatGPT. YouTube и Facebook для Google AI Mode.
Используйте структурированные данные. Они помогают ИИ извлечь информацию в момент запроса. Но не забывайте, что это только один из двух слоёв.
Работайте над плотностью упоминаний. Чем чаще ваш бренд упоминается в авторитетных источниках, тем выше шанс, что модель его «знает».
Позитивный вывод
Разница в чувствительности к контенту между моделями достигает 50 процентных пунктов. Это не проблема, а возможность. Компании, которые поймут, какие факторы значимы для каждой модели, и адаптируют контент под них, получат доступ к аудитории, которую конкуренты упускают.
В мире, где 67-78% факторов дают бинарные решения, побеждают те, кто точно соответствует критериям. Когда разметка работает в момент запроса, а плотность упоминаний - в обучающем корпусе, побеждают те, кто работает с обоими слоями.
